04 · Pipeline de données · Web
Books Price Intelligence
De pages extraites à un jeu de données fiable — et un modèle honnête par-dessus.
Enregistré depuis le projet en fonctionnement
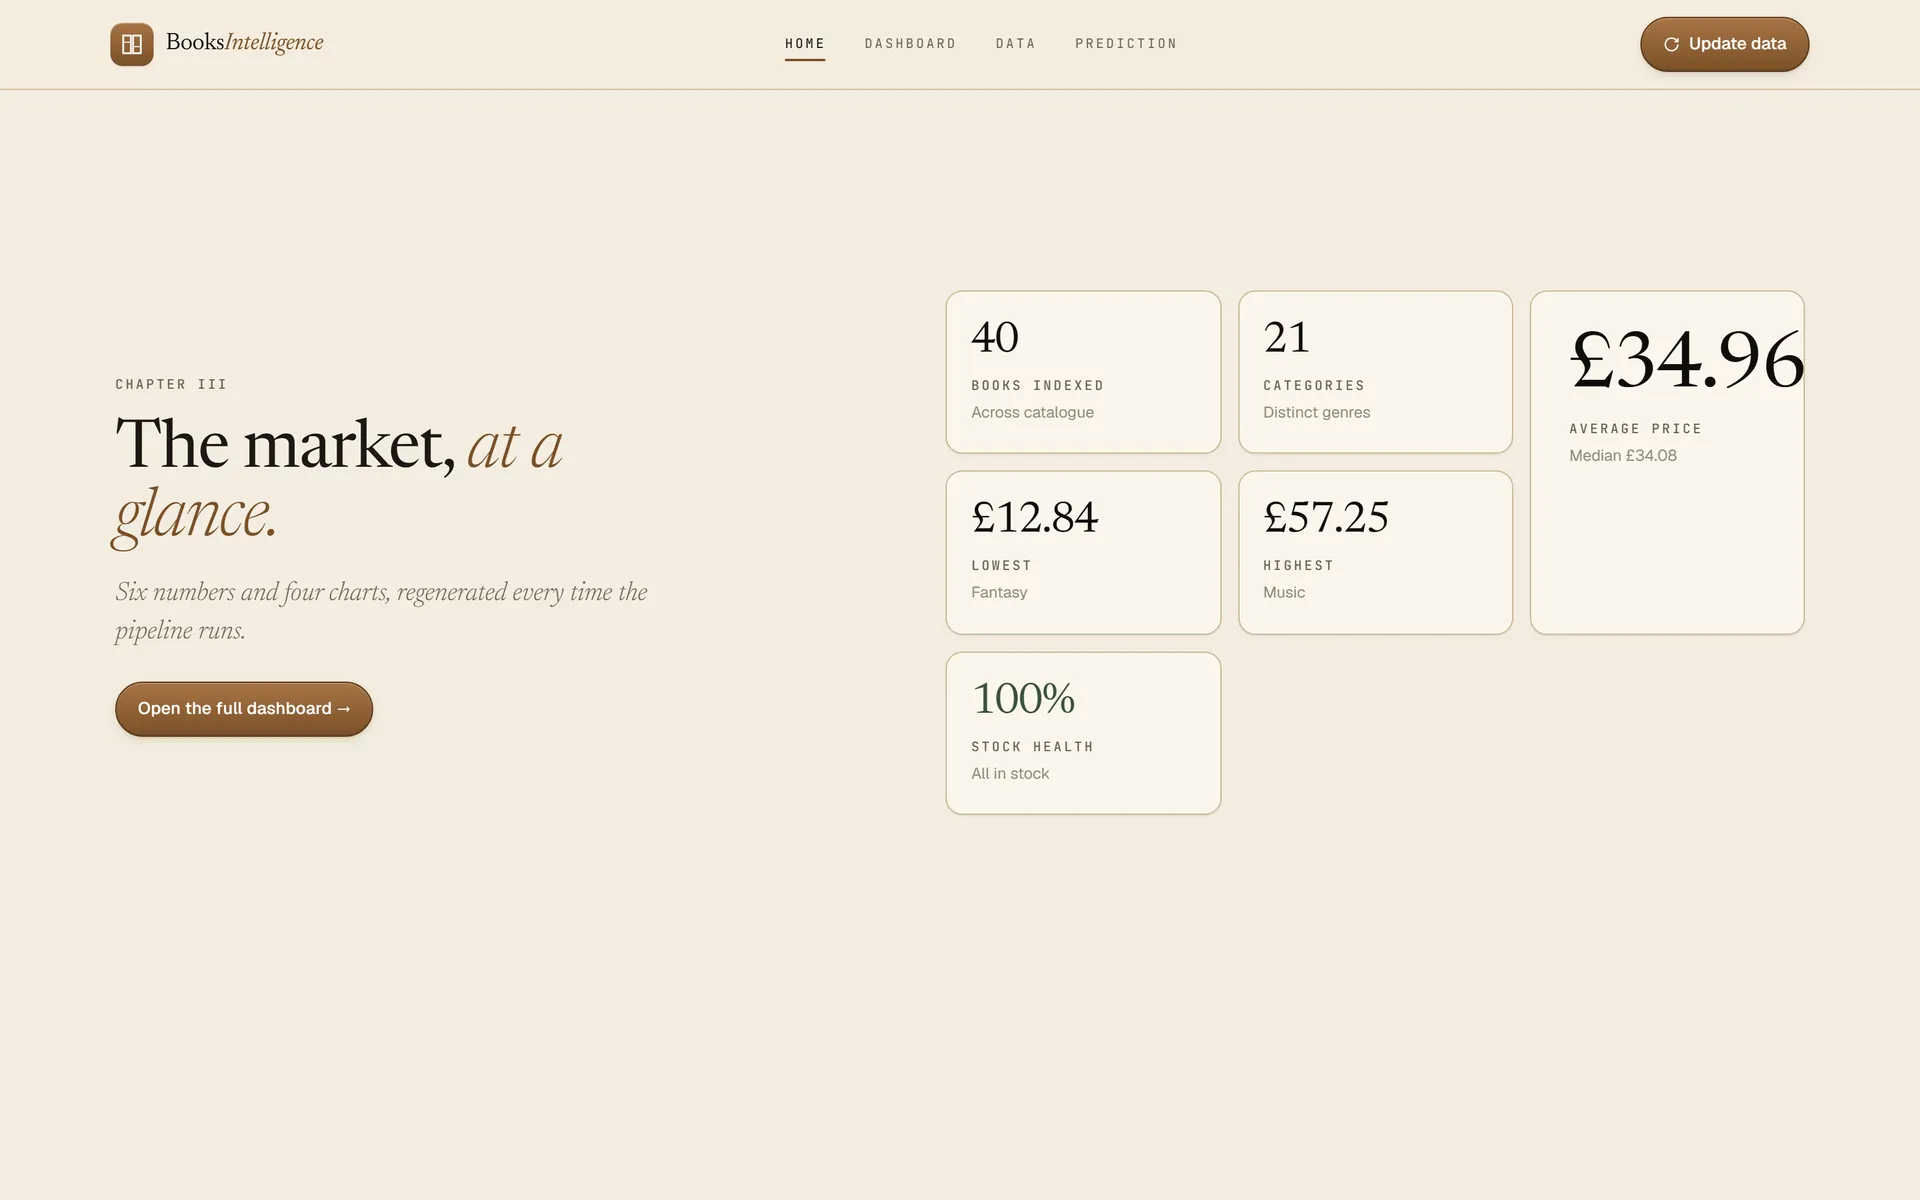
Un pipeline Python de bout en bout : extraire poliment un catalogue d’entraînement public, le nettoyer avec pandas, le stocker dans SQLite, le servir via Flask et l’explorer dans un tableau de bord React — avec une page de régression linéaire qui dit clairement ce qu’elle ne peut pas prédire.
Ce que j’ai construit
- 01
Un scraper pour books.toscrape.com — un bac à sable conçu pour s’entraîner — avec un délai de politesse entre les requêtes et un User-Agent explicite.
- 02
Une étape de nettoyage (prix, notes en toutes lettres, doublons, valeurs nulles), un stockage SQLite et un export CSV.
- 03
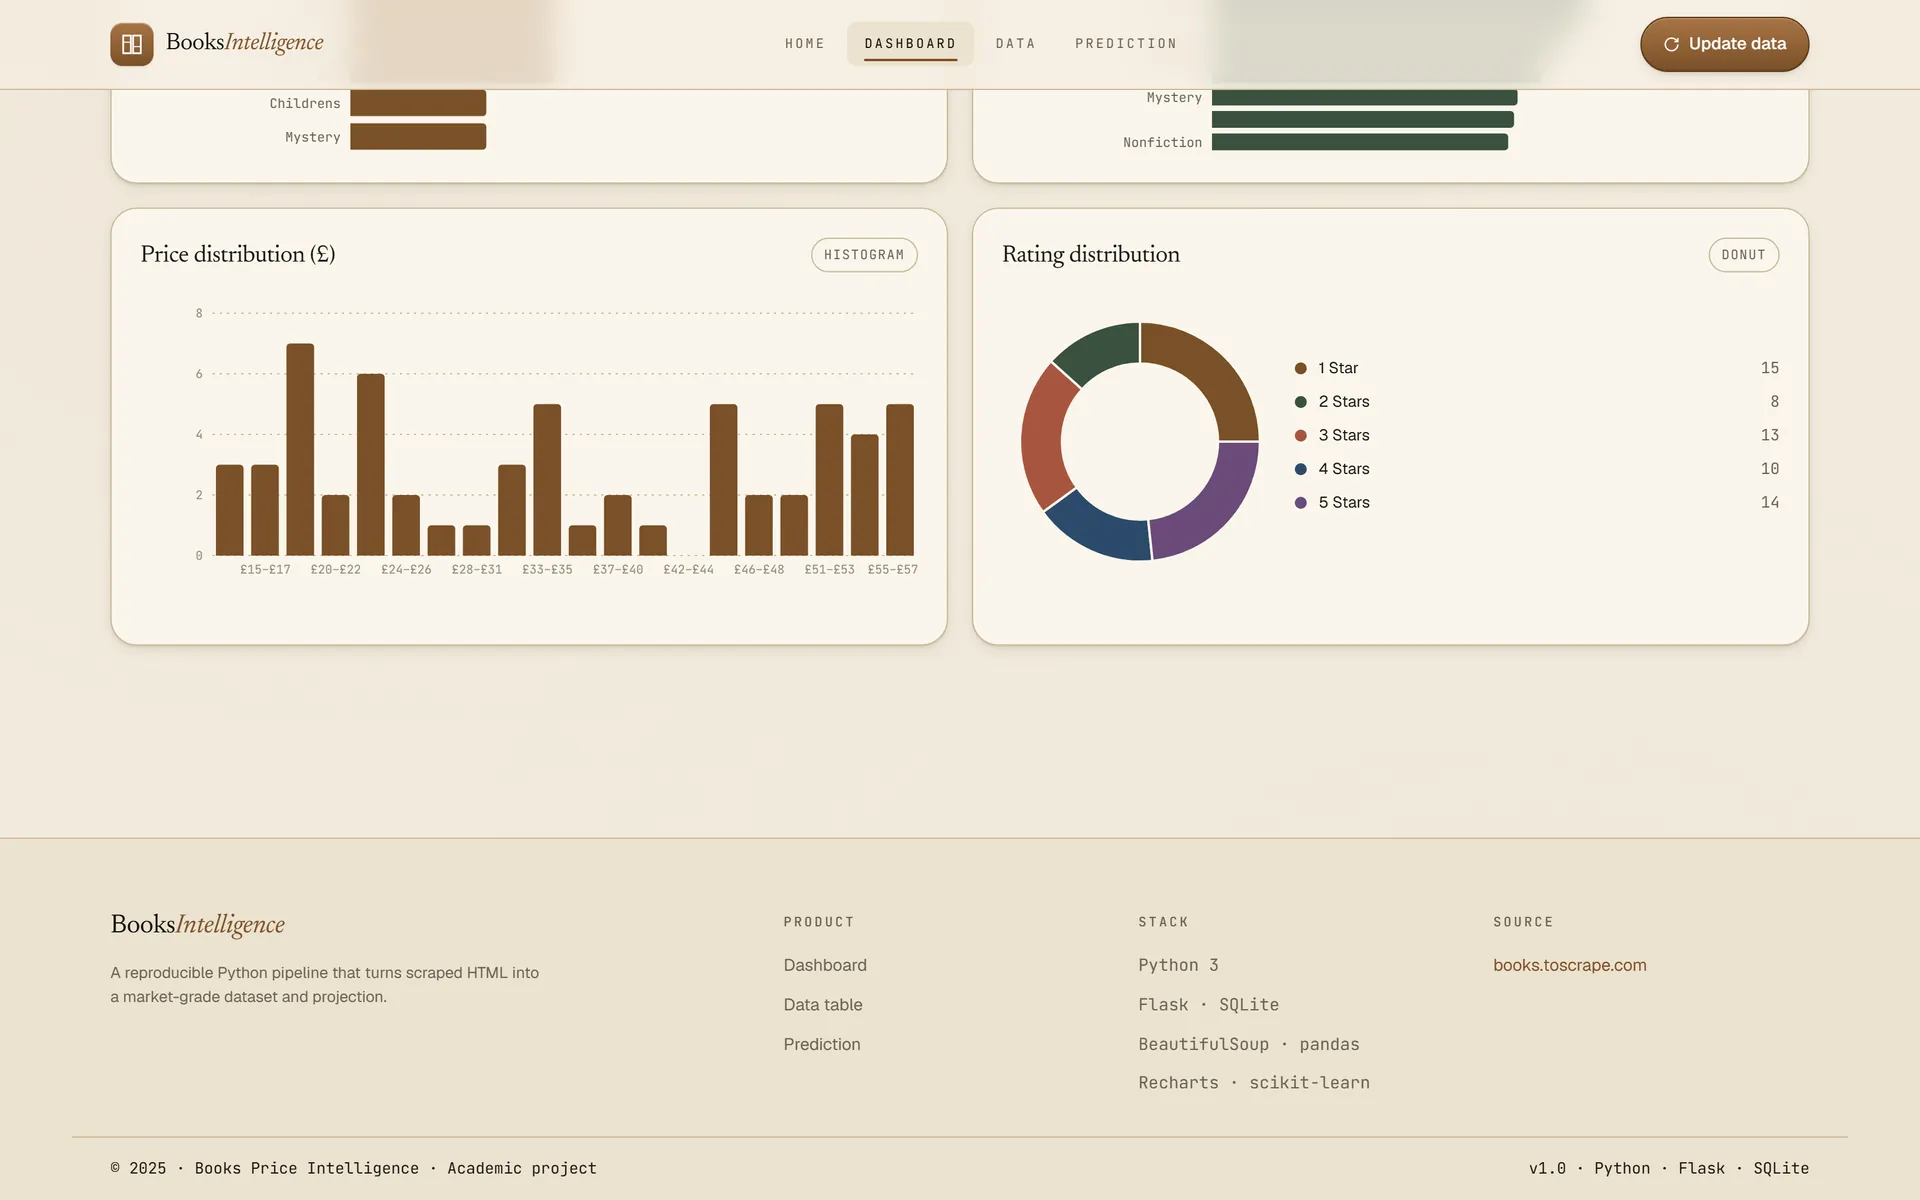
Une API REST Flask avec déclenchement du scraping et suivi de progression, alimentant un tableau de bord React + TypeScript avec filtres et graphiques.
- 04
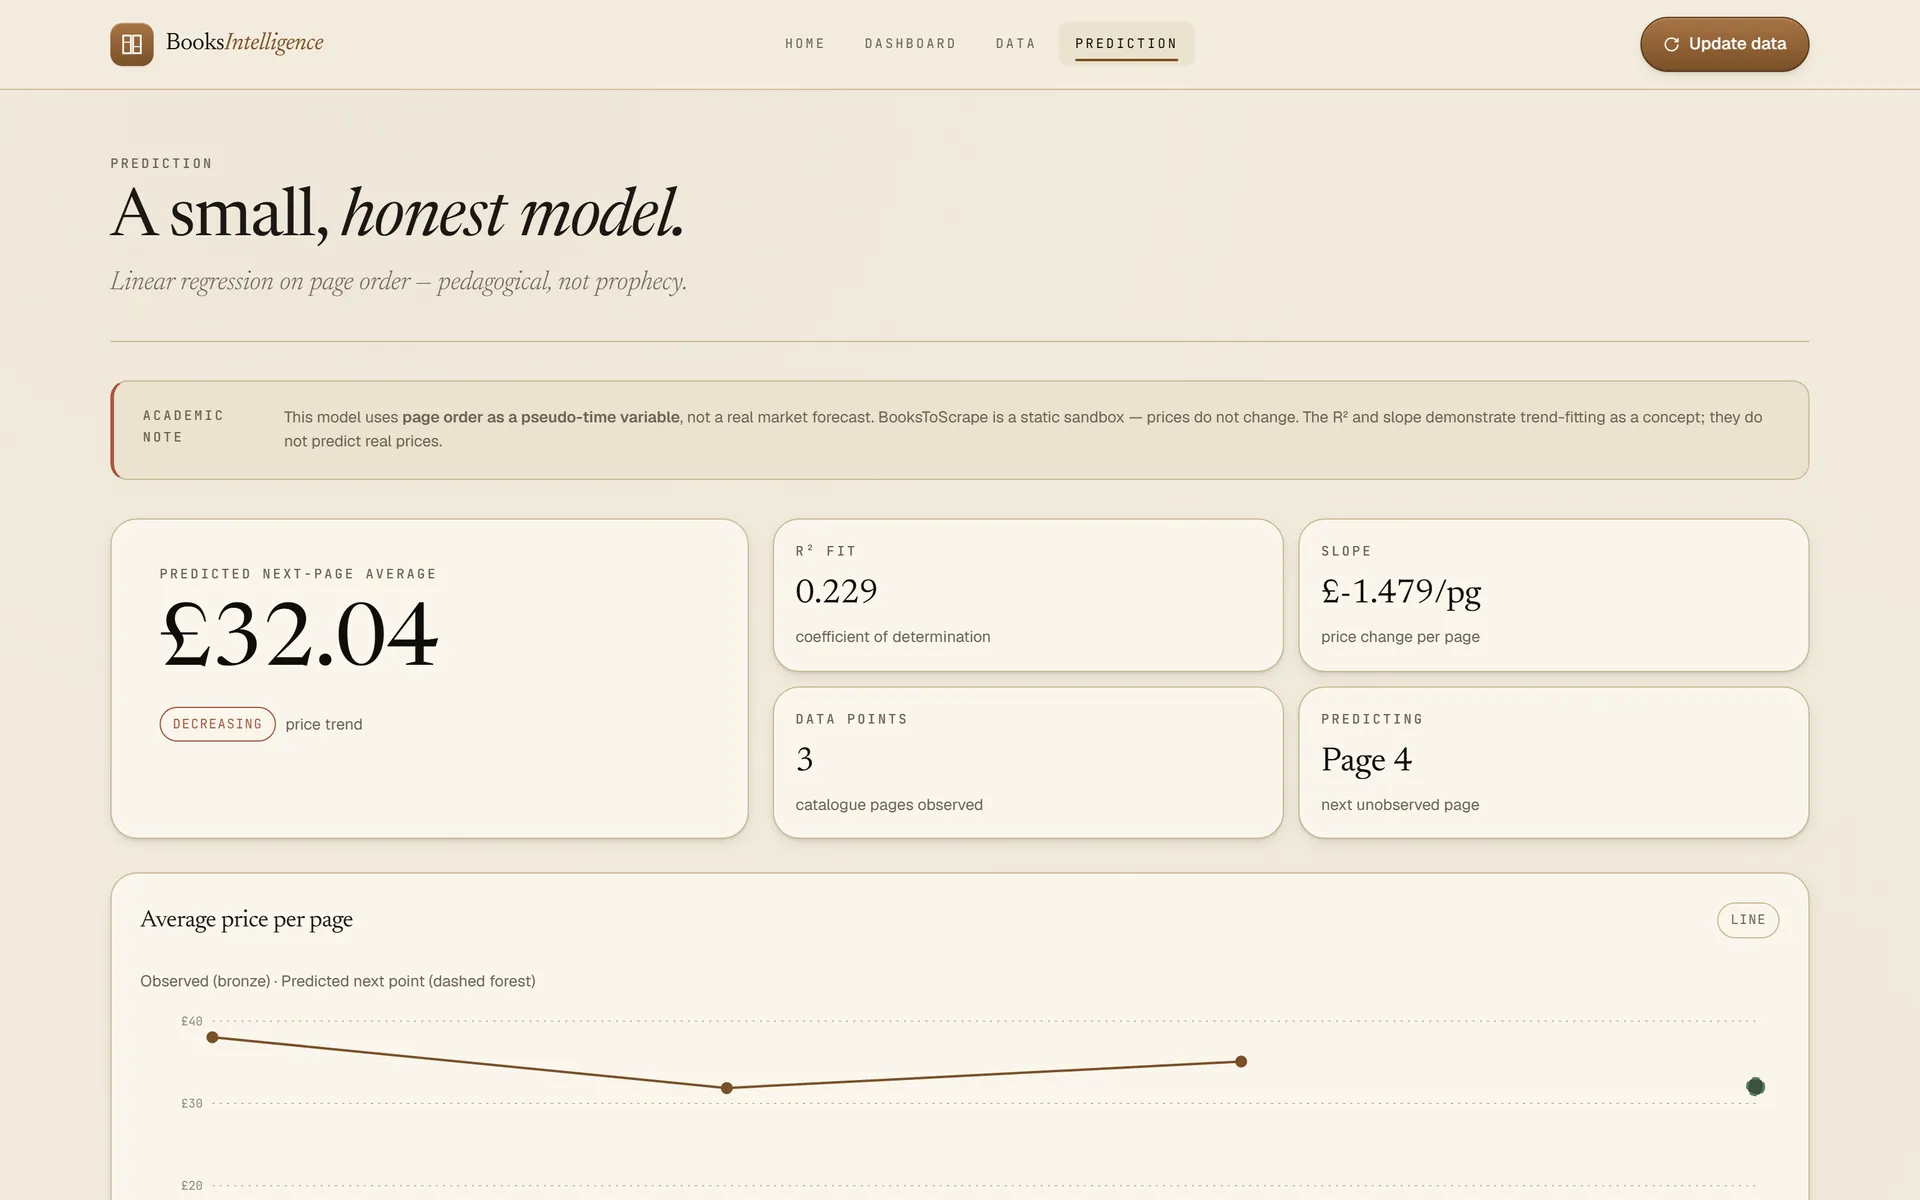
Une régression scikit-learn présentée honnêtement : l’ordre des pages comme variable pseudo-temporelle, « pédagogique, pas prophétique ».
Captures